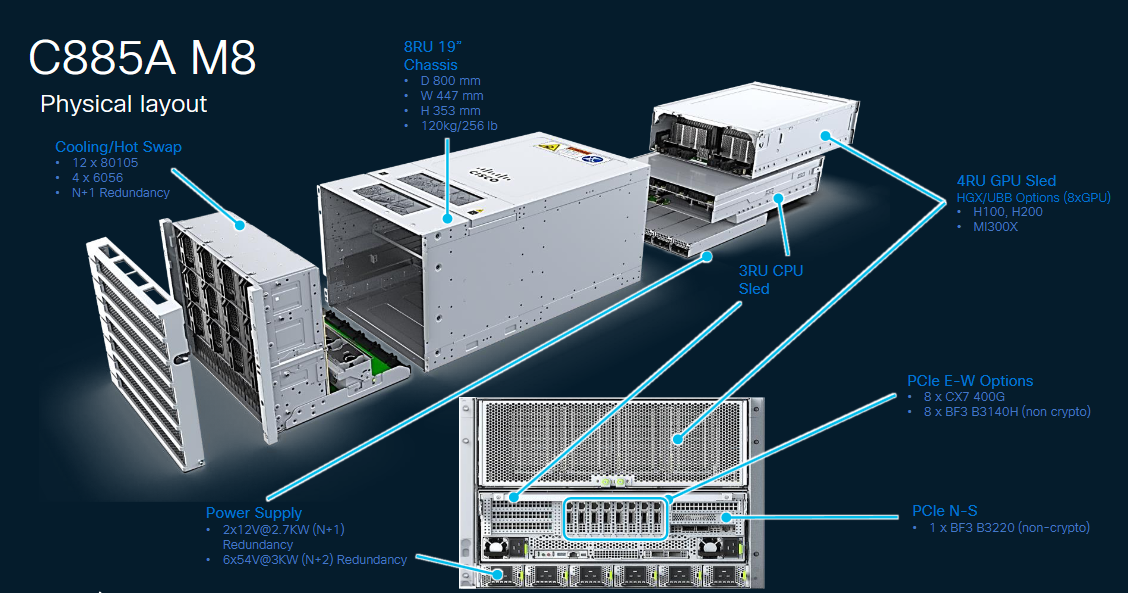
Cisco UCS C885A M8
سرور Cisco UCS C885A M8 یکی از قدرتمندترین سرورهای رکمونت خانواده Cisco UCS C-Series است که برای اجرای Workloadهای بسیار سنگین AI، یادگیری ماشین، LLM و HPC طراحی شده است.
این سرور با بهرهگیری از پردازندههای نسل جدید AMD EPYC 9005 Series، حافظه DDR5، ارتباطات PCIe Gen5 و پشتیبانی از GPUهای قدرتمند، یک پلتفرم مناسب برای زیرساختهای مدرن دیتاسنتر و Applicationهای مبتنی بر پردازش موازی محسوب میشود.
C885A M8 با ظرفیت حافظه بالا، امکان نصب تا 6 ترابایت RAM از نوع DDR5 را فراهم میسازد. این سرور همچنین قابلیت پشتیبانی از 8 عدد GPU را برای پردازشهای سنگین هوش مصنوعی و HPC ارائه میدهد.
مشخصات Cisco UCS C885A M8 در یک نگاه
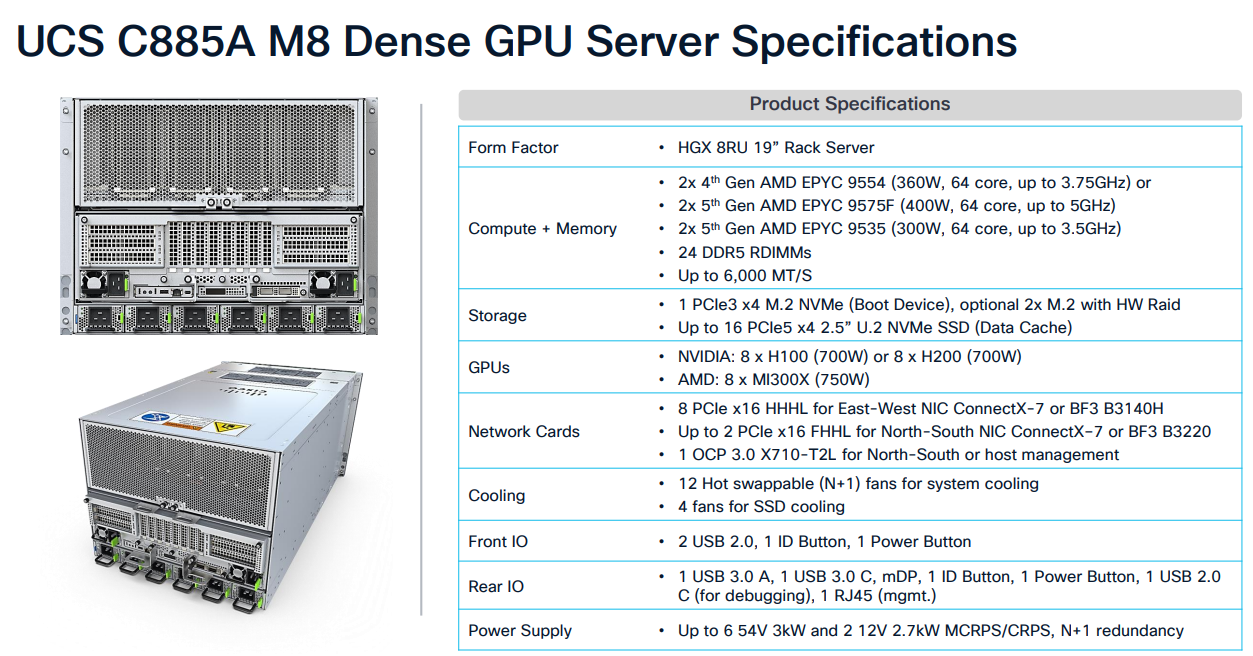
Cisco UCS C885A M8 یک سرور متراکم GPU با فرم فاکتور 8RU است. این پلتفرم از پردازندههای AMD EPYC نسل چهارم و پنجم، حداکثر 24 ماژول DDR5 RDIMM، فضای ذخیرهسازی NVMe و GPUهای پرقدرت برای بارهای کاری AI و HPC پشتیبانی میکند.
گزینههای GPU شامل 8 عدد NVIDIA H100 یا H200 و همچنین 8 عدد AMD MI300X است. برای شبکه نیز رابطهای پرسرعت NVIDIA ConnectX-7 و BlueField-3 برای ترافیک East-West و North-South قابل استفاده هستند.
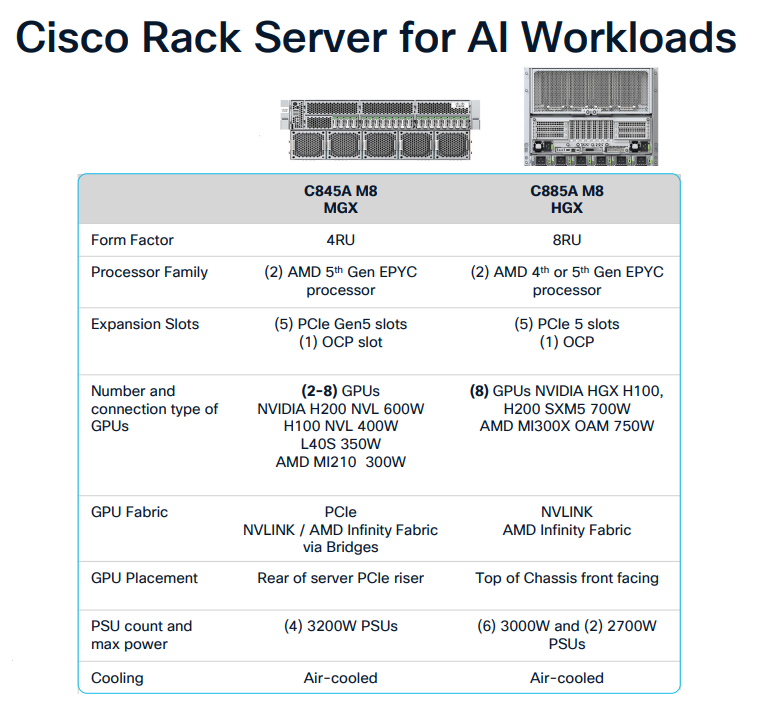
مقایسه Cisco UCS C885A M8 با C845A M8
یکی از تفاوتهای اصلی این دو پلتفرم در معماری GPU است. C845A M8 بر مبنای معماری NVIDIA MGX طراحی شده و انعطافپذیری بالایی برای انتخاب و توسعه GPU ارائه میدهد، در حالی که C885A M8 از معماری NVIDIA HGX برای بارهای کاری بسیار متراکم AI و HPC استفاده میکند.
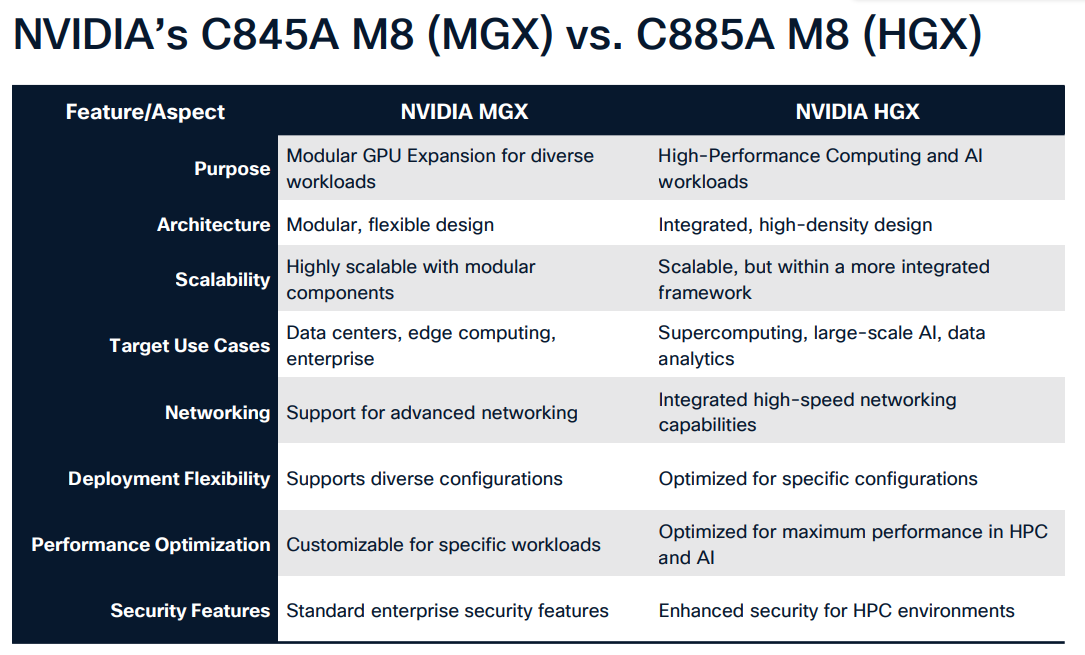
C845A M8 یک سرور 4RU با امکان استفاده از 2 تا 8 GPU است، در حالی که C885A M8 یک پلتفرم 8RU با 8 GPU مبتنی بر HGX است. معماری C885A M8 برای محیطهایی طراحی شده که به حداکثر کارایی GPU، ارتباطات پرسرعت بین GPUها و اجرای مدلهای بزرگ هوش مصنوعی نیاز دارند.
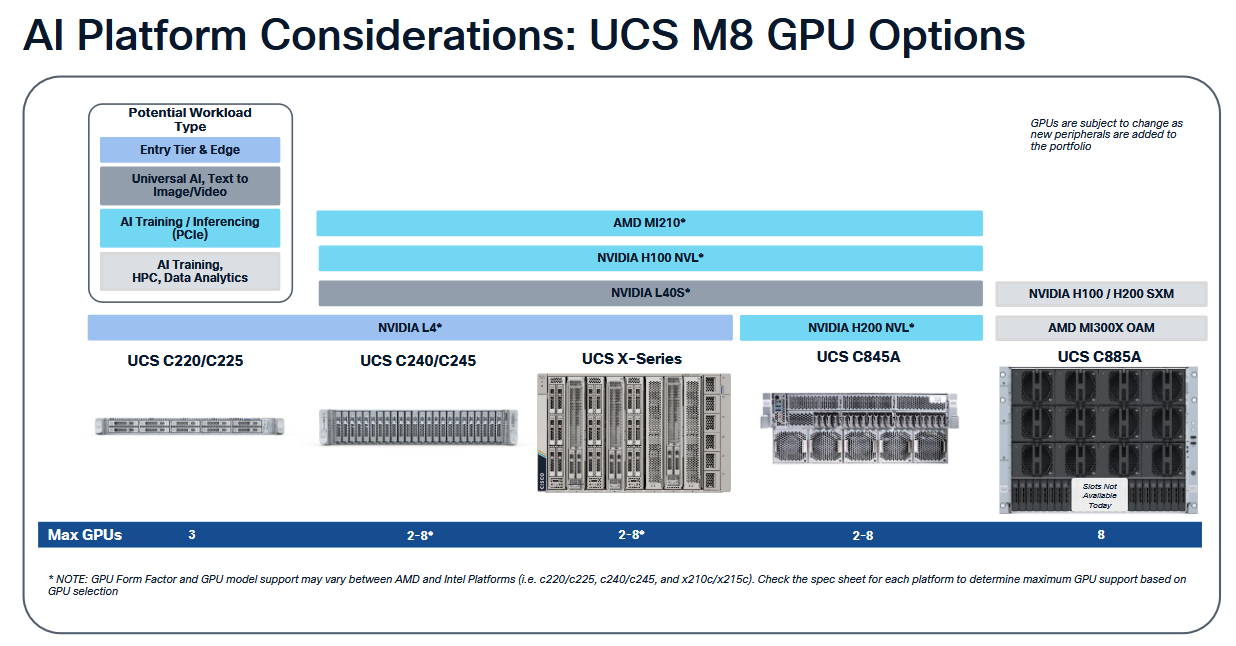
گزینههای GPU در سرورهای Cisco UCS M8
خانواده Cisco UCS M8 طیف متنوعی از GPUها را برای Workloadهای مختلف ارائه میدهد. بسته به نوع سرور میتوان از GPUهایی مانند NVIDIA L4، L40S، H100 NVL، H200 NVL و همچنین AMD MI210 استفاده کرد. در C885A M8 گزینههای NVIDIA H100/H200 SXM و AMD MI300X OAM برای پردازشهای بسیار سنگین AI Training، HPC و Data Analytics در نظر گرفته شدهاند.
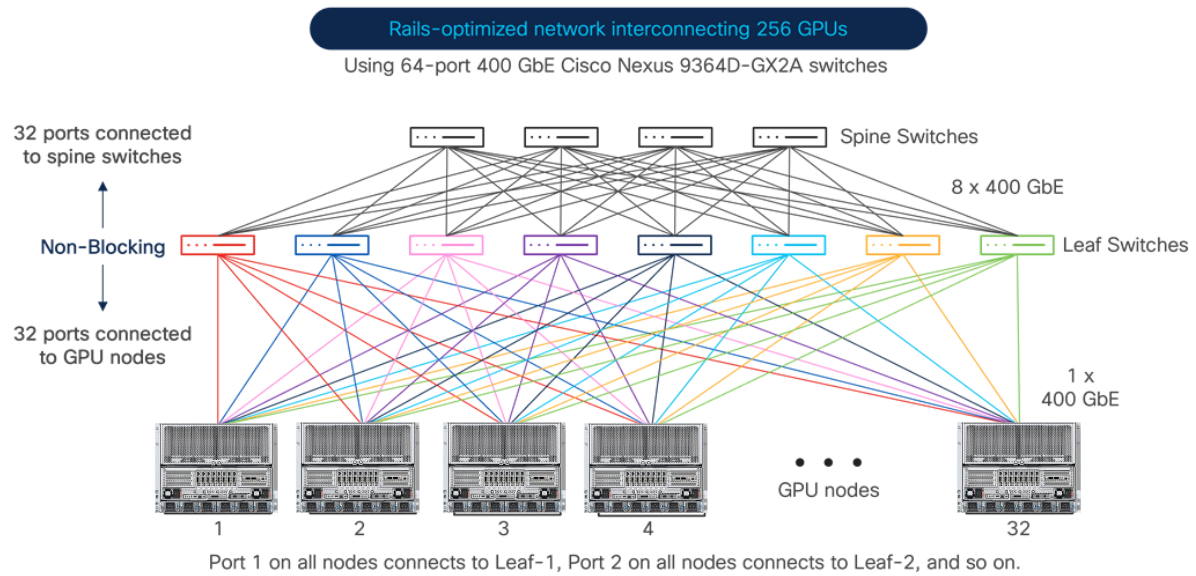
طراحی شبکه Backend برای کلاسترهای بزرگ GPU
در پروژههای بزرگ هوش مصنوعی، تنها قدرت پردازشی GPU اهمیت ندارد و شبکه ارتباطی بین GPU Nodeها نیز باید پهنای باند بالا و تأخیر بسیار پایین داشته باشد. برای توسعه کلاسترهای بزرگ میتوان از معماری Leaf-Spine با شبکه 400GbE استفاده کرد.
نمونه طراحی نشان داده شده، یک شبکه Non-Blocking برای اتصال 256 GPU است که با استفاده از سوئیچهای Cisco Nexus 9364D-GX2A با پورتهای 400GbE پیادهسازی میشود. این معماری امکان ایجاد Backend GPU Network با پهنای باند بالا برای AI Training در مقیاس بزرگ را فراهم میکند.
مدیریت Cisco UCS C885A M8 توسط Cisco Intersight
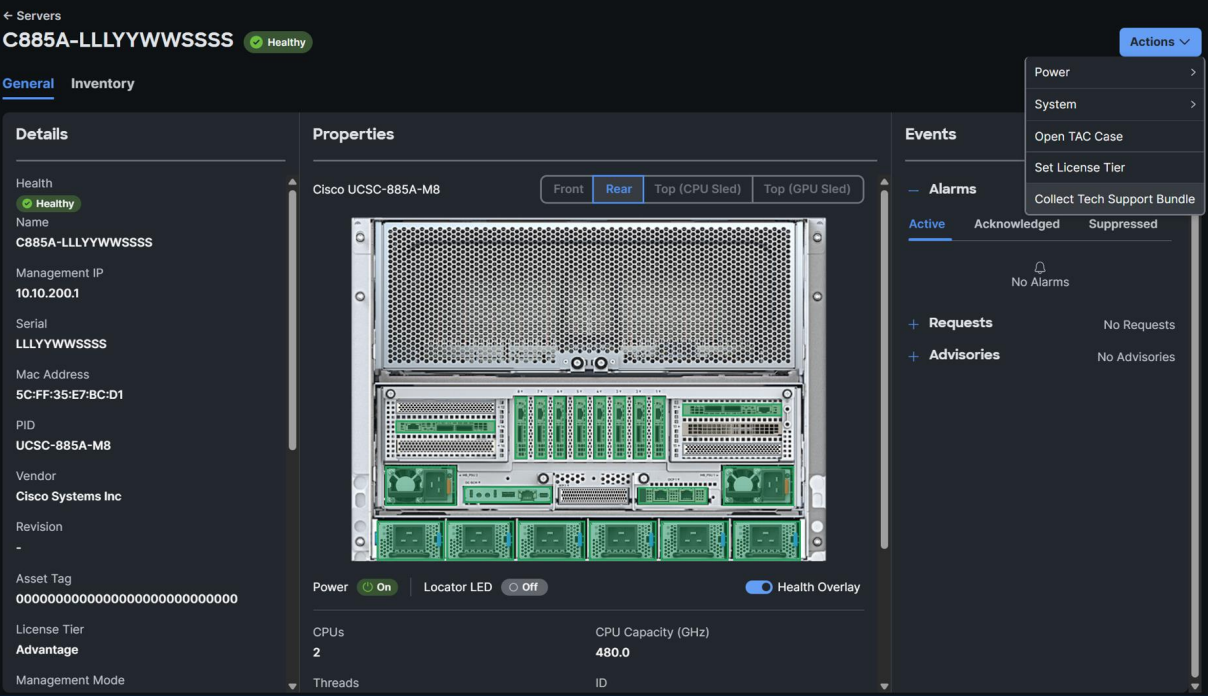
سرور C885A M8 از طریق Cisco Intersight قابل مدیریت است. Intersight امکان مشاهده وضعیت سلامت سرور، Inventory سختافزار، وضعیت CPU و اجزای سیستم، رخدادها، Alarmها و انجام عملیات مدیریتی و جمعآوری Tech Support Bundle را از یک رابط متمرکز فراهم میکند.